Regresyon analizi, bir yada birden daha fazla bağımsız değişkenin, bağımlı bir değişkenle arasındaki ilişkiyi matematiksel bir denklem olarak orataya koymak için kullanılır. Burada;
Y : Bağımlı değişken
X: Bağımsız değişken
B: Katsayılar
E: Artıklar
olmak üzere Y=B0+B1+B2X2+…+BkXk+ei şeklinde bir denklem elde edilir. Böylece "şu "X" verisi için "Y" değeri bu olacaktır." şeklinde tahminler yapılabilir. ( Örnekte incelenecek veri setini buradan indirebilirsiniz... )
Burada "y"(Vücut ağırlığı)" değişkeni bağımlı veri, "x"(Vucudun farklı bölümlerinin ölçüleri) değişkenleri ise bağımsız verilerdir.
SPSS' de " Analyze > Regression > Linear "
Bu seçimler yapıldıktan sonra sonuçlar aşağıdaki gibi olacaktır.
Bu tablodaki "Adjusted R Square" değeri oluşturulan denklemin tahmin gücünü göstermektedir. Bu modelin tahmin gücü %99.9' dur.
Bu tabloda "Sig." değer 0.000<0.05 olduğu için oluşturulan modelin anlamlı bir model olduğu yorumu yapılabilir.
Bu tablodan modelin matematiksel hali oluşturulabilir ve katsayıların bağımlı değişken üzerinde anlamlı bir etkiye sahip olup olmadıkları yorumu yapılabilir. Burada "Midarm Circumference" değişkeninin "Sig." değeri 0.170>0.05 olduğu için bu değişkenin bağımlı değişken üzerinde anlamlı bir etkisi yoktur. Böyle bir durumda "Stepwise Regression" yöntemi kullanılır.
ANOVA etiketine sahip kayıtlar gösteriliyor. Tüm kayıtları göster
17 Kasım 2012 Cumartesi
12 Kasım 2012 Pazartesi
SPSS:Univariate ANOVA
Univariate ANOVA, iki yada ikiden daha fazla faktöre ait değişkenlerin ortalamalarını karşılaştırmak için kullanıllır. One-Way ANOVA' dan farkı iki yada ikiden daha fazla faktörün olmasıdır. ANOVA testiyle hangi faktörün bağımlı değişken üzerinde anlamlı bir etkisi olup olmadığı tespit edilir. Post Hoc testleriyle ise eğer faktör düzeyleri arasında bir farklılık var ise bu faklılığın hangi düzeyler arasında olduğu bulunur. Varsamyımlar One-Way ANOVA ile aynıdır. Nomallik ve varyansların homojenliği. (Örnekte incelencek veri setini buradan indirebilirsiniz.)
Burada fakörler "Shelf" ve "Store" sütunları, bağımlı değişken ise "Sales" sütunudur. Bu veri seti, bir süpermarketin iki farklı şubesindeki(Store), üç farklı raftaki(Shelf) ürünlerin satış miktarını(Sales) gösteriyor. Teste başlamadan önce normallik testi yapılmalıdır. Burada veriler normal dağılımlıdır. Ortalamaları karşılaştırmak için öncelikle hipotezler kurulmalıdır.
H0: %95 güvenle, faktör düzeylerinin ortalamaları arasında istatistiksel olarak anlamlı bir farklılk yoktur.
H1: %95 güvenle, faktör düzeylerinin ortalamaları arasında istatistiksel olarak anlamlı bir farklılk vardır
SPSS' de " Analyze > General Linear Models > Univariate " (Resimleri büyütmek için üzerine tıklayın...)
Burada, eğer fakör düzeyleri rastgele eşleştirilmiş olsaydı ilgili faktör yada faktörler "Random Factor" bölümüne atılırdı.Eğer faktörlerin değişkenleri kantitativ(nicel, sayısal) olsaydı bu sefer ilgili faktör yada faktörler "Covariate" bölümüne atılırdı.
"Model" bölümünde, hangi faktörlerin yada bu faktörlerin etkileşimlerinin, bağımlı değişken üzerinde etkisi olup olmadığı araştırılıyorsa onlar seçilir. "Full factorial" bölümü işaretli olduğu zaman, SPSS tüm faktörleri ve bu faktörlerin olası bütün etkileşimlerini modele koyar. "Custom" bölümünden ise isteğe göre bir model oluşturulabilir.
"Post Hoc" bölümünde, faktör düzeyleri arasındaki olası farklılıklara karşın, bu farklılıkların hangi düzeyler arasında olduğunu tespit etmek için ilgili testler seçilir. Varyansların homojen olması durumunda genellikle
"Tukey" testi tercih edilir. Varyansların homojen olmaması durumunda ise genellikle " Tamhane' s T2" testi tercih edilir.
"Sig" değeri 0.315 > 0.05 olduğu için faktörlerin varyansları homojendir.
Bu tabloda "Store" ve "Store*Shelf" faktörlerinin "Sig" değerleri 0.550 > 0.05 ve 0.467 > 0.05 olduğu için bu faktörler için H0 hipotezleri kabul edilir. Yani " %95 güvenle, bu faktör düzeylerinin ortalamaları arasında, istatistiksel olarak anlamlı bir farklılık yoktur." denilebilir. Dolayısıyla bu faktörlerin satışlar üzerinde anlamlı bir etkisi yoktur. Ancak "Shelf" fakörünün "Sig" değeri 0.001 < 0.05 olduğu için H0 hipotezi reddedilir. Yani "%95 güvenle,"Shelf" faktörünün düzeylerinin ortalamaları arasında, istatistiksel olarak anlamlı bir farklılık vardır." denilebilir. Bu farklılıkların hangi düzeyler arasında olduğunu tespit etmek için "Tukey" testinin sonuçları incelenmelidir.
Bu tabloda faktör düzeyleri ve bu faktör düzeylerinin ortalamaları arasındaki farklar sayısal olarak verilmiştir. Tablodaki bu sayısal farklılıkların yanındaki yıldız(*) işereti, bu farklılıkların anlamlı bir farklılık olduğunu göstermektedir. Dolayısıla tablo incelendiğinde 3. faktör düzyeinin ortalamasının diğer iki düzeyin ortalamasından farklı olduğu görülür.
Son olarak "Shelf" faktörünün ortalama tablosu incelendiğinde, 3.düzeyin(3. raf çeşidinin) ortalamasının diğerlerinden daha büyük olduğu görülür. Yani "3. raftaki satışlar diğerlerinden daha fazladır." yorumu yapılabilir.
Etiketler:
ANOVA,
Çok Faktörlü ANOVA,
Data Analyze,
Data Set,
Deney Tasarımı,
Genel Lineer Modeller,
General Linear Models,
SPSS,
Univarite,
Veri Analizi,
Veri Seti,
Volkan İset
6 Kasım 2012 Salı
SPSS:One Way ANOVA(Tek Yönlü Varyans Analizi)
Tek yönlü varyans analizi, bir faktör çatısı altında, iki yada ikiden daha fazla bağımsız grubun ortalamalarını karşılaştırmak için kullanılır. Tek yönlü varyans analizinde iki temel varsayım vardır. Her grup normal dağılımlıdır ve göreceli olarak grupların varyansları homojendir. (Örnekte kullanılacak veri setini buradan indirebilirsiniz...)
Bu veri seti, bir yemek şirketine ait ürün çeşitlerinin satış miktarlarını göstermektedir. Burada "sales" değişkeni(Bağımlı değişken) satış miktarını, "design"(Faktör) değişkeni ise ürün çeşitlerini ifade etmektedir. Burada ürün çeşitlerinin satış miktarları birbirinden bağımsızdır ve normal dağılıma sahiptir. (Normallik testinin nasıl yapıldığına buradan bakabilirsiniz.) Dolayısıyla bu grupların satış miktarlarının ortalamalarını karşılaştırmak için en uygun test tek yönlü varyans analizi olur. Öncelikle hipotezler kurulmalıdır.
Varyansların homojenliği testi için hipotezler;
H0: %95 güvenle grup varyanslar homojendir.
H1: %95 güvenle grup varyansları homojen değildir.
Tek yönlü varyans analizi için hipotezler;
H0: %95 güvenle, grupların ortalamaları arasında istatistiksel olarak anlamlı bir farklılık yoktur.
H1:%95 güvenle, grupların ortalamaları arasında istatistiksel olarak anlamlı bir farklılık vardır.
SPSS' de "Analyze > Compare Means > One-Way ANOVA"
Burada homojenlik testi için, "Options" bölümünden "Homogeneity of variance test" bölümü seçilir. İsteğe bağlı olarak "Descriptives" seçeneği işaretlenerek tanımlayıcı istatistikler de hesaplatılabilir.
"Post Hoc" bölümünden ise varyansın homojen olup olmamasına göre yapılması istenen test yada testler seçilir.
Burada varyansların homojen olması halinde(Equal variances Assumed) yapılacak testlerden, genellikle "Tukey" testi tercih edilir. Veri sayısının az olduğu zamanlarda "Bonferroni" testi de seçilebilir. Varyansların homojen olmaması halinde(Equal Variances Not Assumed) yapılacak testlerden ise genellikle "Tamhane's T2" testi tercih edilir.
Bu seçimler yapıldıtan sonra sonuçlar aşağıdaki gibi olacaktır.
Burada "Sig." değeri 0.729>0.05 olduğu için homojenlik testi için olan H0 hipotezi kabul edilir. Yani " %95 güvenle grupların varyansları homojendir." denilebilir.
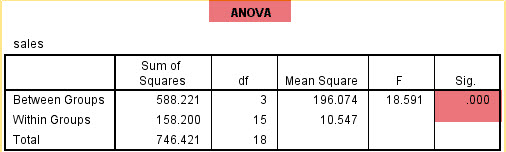
ANOVA tablosu incelendiğinde, "Sig." değeri 0.000<0.05 olduğu için tek yönlü varyans analizi için olan H0 hipotezi reddedilir. Yani " %95 güvenle, grupların ortalamaları arasında istatistiksel olarak anlamlı bir farklılık vardır." denilebilir.
Hangi grupların ortalamaları arasında farklılıklar olduğunu görmek için bir sonraki tablo incelenir. (Tabloyu büyütmek için üzerine tıklayınız.)
Burada grupların varyansları homojen olduğu için "Tukey" testi incelenir(Eğer homojen olmasaydı "Tamhane" testi incelenirdi). Bu tabloda her grubun ikişerli karşılaştırmaları yapılmış ve bu karşılaştırılan grupların ortalamaları arasındaki farklar(Mean Difference) sayısal olarak verilmiştir. Bu sayısal değerlerin yanında bir yıldız (*) işaretinin bulunması bu ikilinin ortalamaları arasında anlamlı bir farklılık olduğunu göstermektedir. Tablo incelendiğinde 1-4, 2-4 ve 3-4 ikililerinin yanında bir yıldız(*) işareti olduğu görülür. Yani bu ikililerin ortalamaları arasında anlamlı bir farklılık vardır.
Son olarak "Descriptive" tablosu incelendiğinde 4. grubun ortalamasının diğer gruplardan daha büyük olduğu görülür. Yani 4. ürün çeşidin satış miktarının, diğer grupların satış miktarlarından daha fazla olduğu söylenebilir.
Kaydol:
Kayıtlar (Atom)